

当 DeepSeek 画出 Super Agent 的蓝图时,领铄智能已经在生产环境实践出 4 条技术选择
从主助手、执行助手与主动助理的分工出发,分享 Super Agent 在生产环境中的四项技术选择,以及升级交接、工具迟到回包等工程实践。
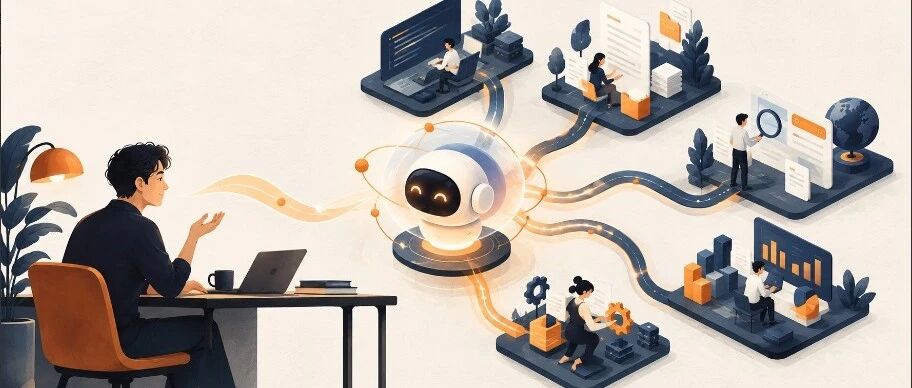
前两天,DeepSeek Harness 团队发了一篇《Super-agent 设计探索:迈向更自主的 Agent 系统》,圈里刷了一波。
我们看完的第一反应是:这不就是我们最近几个月一直在死磕的方向吗?
连续、高效、主动、持久——一个主助手负责对话,多个执行助手并行干活,用户永远只需要跟一个人(哦不,一个 Agent)说话。
他们画了一张很清晰的架构图:Router 常驻、Worker 隔离、事件驱动、外部 Watchdog。
我们的实现思路很相似。
但真正把这套东西跑上生产、让真实用户每天在用之后,我们就会遇到一些论文里不会写、但做过的人一看就懂的问题。
这篇文章不是来比谁做得更好的。
DeepSeek 讲的是方向,我们讲的是踩坑。同一个目标,不同的工程取舍,都值得聊。
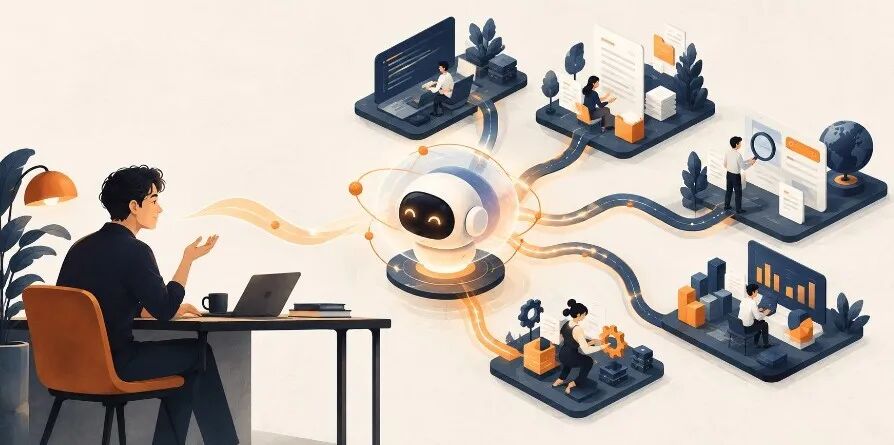
一个持续对话的主助手,连接多项并行工作
先说说领铄智能在做什么
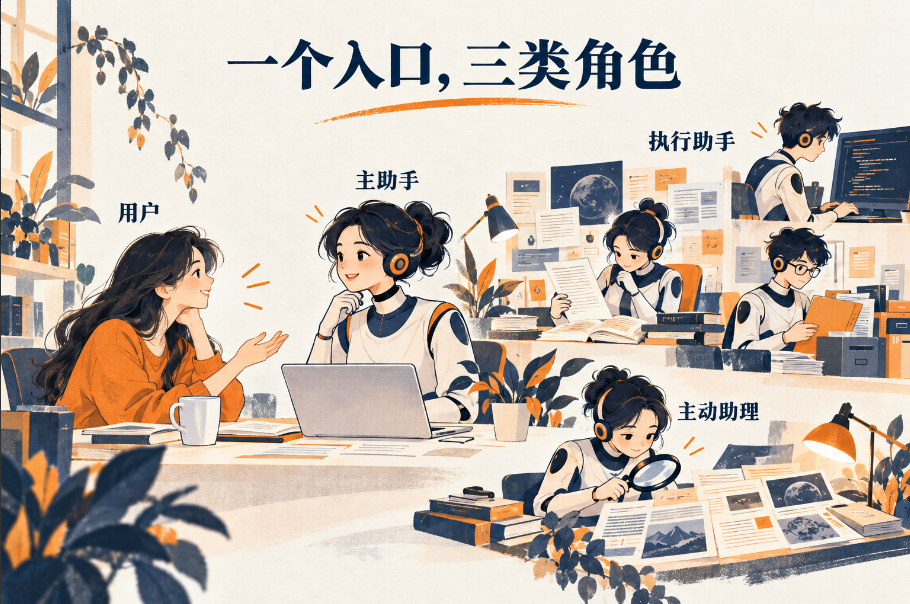
三层角色示意图
我们的系统有三层角色。
主助手一直跟你聊着天。 你想到什么、补充什么、改需求,都直接跟它说。它负责理解你的意图,把活儿派下去,然后把结果汇总给你。
执行助手在后台并行干活。 每个任务开一个独立的执行助手,专心把事情做完——写代码、查资料、跑测试、修 bug。它可以把进度和结果直接发给你看,但你的回复永远回到主助手那里。
主动助理在后台自己转。 它围绕你已有的目标,定期去看看有没有新东西、有没有值得注意的变化,筛选出有价值的信息,再交给主助手决定要不要告诉你。
听起来和 DeepSeek 的 Router/Worker 模型很像,对吧?
确实是同一个方向。但做着做着,我们在几个地方做了不同的选择。
第一个选择:执行助手要不要直接对用户说话?
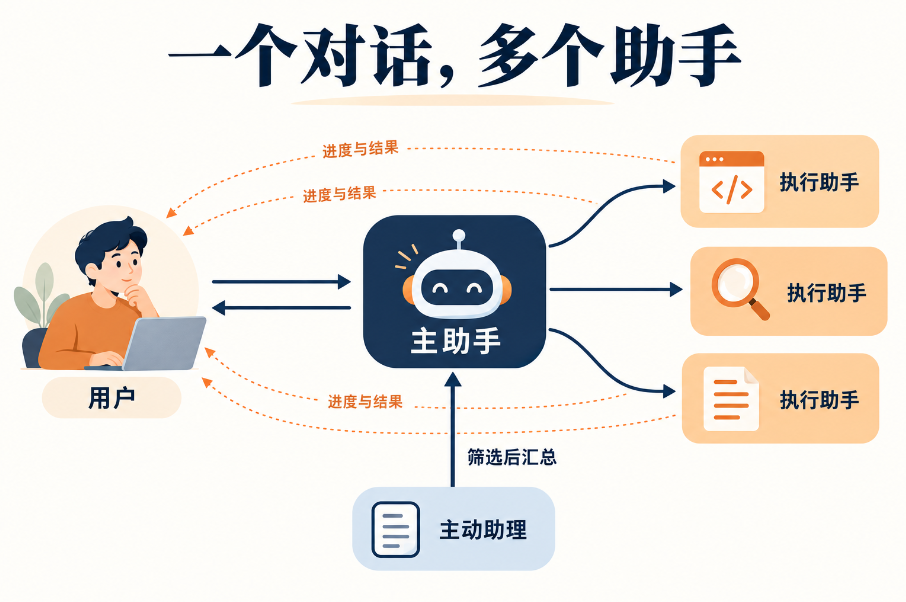
主助手 / 执行助手 / 主动助理,谁对用户说话
DeepSeek 的方案里,Worker 不直接对用户说话,所有输出都走 Router。
我们一开始也是这么想的。
但真实用起来发现不行——有些任务执行到一半,用户需要看到中间结果才能放心。
比如修一个 bug:执行助手跑了测试、定位了问题、提交了 PR。如果这些都得等主助手转述一遍,用户会觉得很脱节。
所以我们做了不对称的消息发布:执行助手可以直接把进度、结果、文件发给用户,但用户的回复永远回到主助手。
这意味着什么?
你不会养出十几段各自独立的对话。你不用记住"这件事我在跟谁聊"。
你看到执行助手发来的进展,有想法直接在主对话里说,主助手会把你的新要求送到对应的执行助手那里。
这一点我们自己用下来感触特别深。
之前我们同时盯五六个 PR,每个 PR 开一个会话,来回切得头晕。
现在我们把十来个想法丢给系统,它分别开执行助手去推进 PR、等 review、等合并。我只需要在一个对话里看汇总、做决策、提新要求。
人的注意力是有限的。DeepSeek 的文章里也提到了——一个人大约只能同时跟 3 到 5 个会话。
我们的解法不是让用户管理更少的会话,而是让用户根本不用管理会话。
第二个选择:用户插话的时候,工具还在跑怎么办?
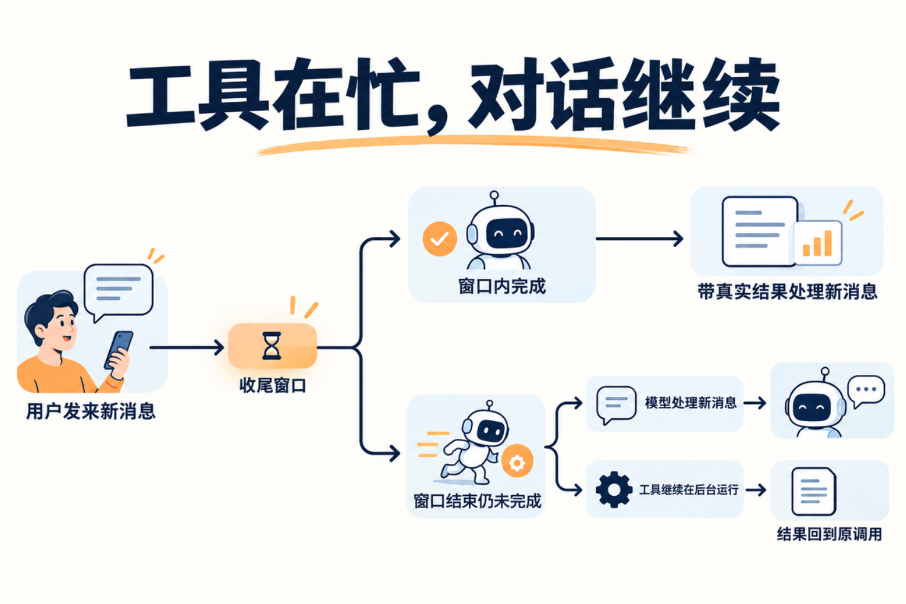
新消息到来后的收尾机制
这是我们觉得最有意思的一个问题。
想象一下:你让 Agent 查一份资料,它正在调工具跑搜索。跑了一半,你突然想起来补充一句——"对了,顺便帮我对比一下竞品的数据"。
这时候系统面临一个选择:是等工具跑完再处理你的新消息,还是立刻中断、先回你?
DeepSeek 的文章里提到了异步工具——工具在后台跑,新消息不用等它结束。
这个方向我们完全认同。但具体到"怎么插进去",我们磨了很久。
我们的做法是:给正在运行的工具一个收尾窗口。
你发来新消息的那一刻,如果工具刚好在这个窗口内能跑完,那就等它跑完,带着真实结果一起处理你的新需求。
如果窗口内跑不完,就先把工具切到后台,模型先响应你的新消息。工具继续跑,跑完了再把结果补回原来那次调用,交给模型继续处理。
窗口多长合适?
我们翻了线上的真实调用记录,大约 82% 的工具调用在两秒内就能返回。
也就是说,窗口如果设成两秒,大部分情况下你的新消息到了,工具刚好也快完了,等一下就能拿到完整结果,用户体验更连贯。
现在线上跑的是一秒窗口。两秒的改动已经合进代码,还没部署上去。
我们也清楚,这个比例受具体使用场景影响很大——高频用户的短工具调用多,比例就高;长任务多的场景,比例就低。
再说一个容易混淆的地方。
DeepSeek 的文章里也提到了异步工具——工具在后台跑,新消息不用等它结束。这套东西 Harness 里已经有了,默认还没打开。他们公开的研究原型每两秒跑一轮自己的调度。
这和我们的工具收尾窗口、以及外部事件合并窗口,表面上都是"两秒",但解决的不是同一个问题。
他们是整个系统的调度节奏,我们是用户插话时的响应策略。
殊途同归的是,大家都意识到:Agent 不能让用户等。忙的时候,也得能听见人说话。
第三个选择:主动助理要不要直接打扰用户?
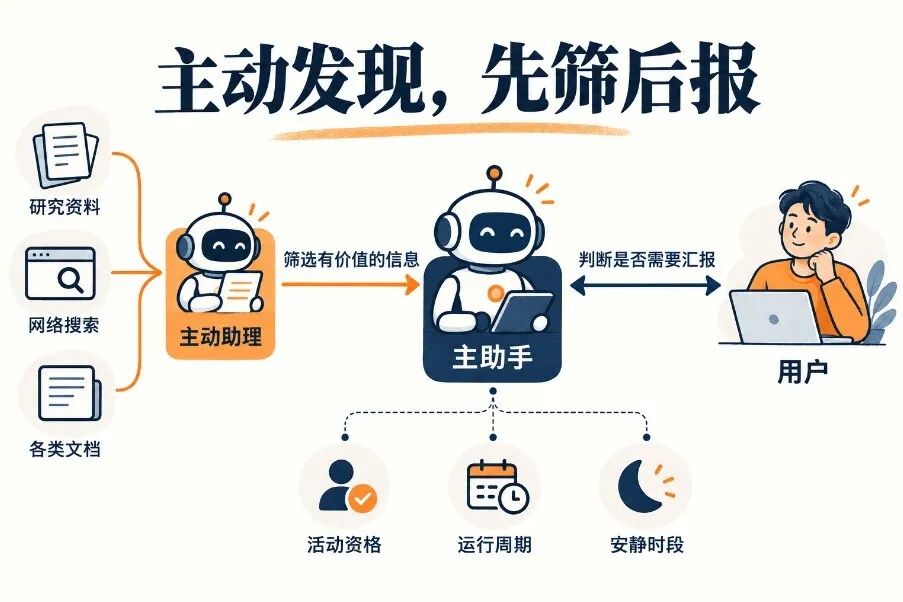
主动助理先筛再汇总
DeepSeek 文章里提到,他们的内部实例会在没人 @ 的时候自己去看问题、尝试修复。
听起来很酷,对吧?
我们也有主动助理,但我们给它设了一道闸:它不直接给用户发消息。
主动助理在后台自己跑,围绕用户已有的目标去搜集信息、发现变化。
但它觉得有价值的东西,先交给主助手过一遍。主助手判断要不要告诉用户、怎么告诉用户。
为什么要多这一层?
因为"打扰用户"的成本很高。
你试一下就知道了——一个 Agent 动不动就给你发"我发现了这个""我注意到了那个",用不了一天你就想把它关了。
主动是好事,但过度主动就是骚扰。
所以我们的主动助理有自己的节奏:有活动资格限制、有运行周期、有安静时段。
它更像一个默默帮你盯梢的助理,有重要的事才通过主助手汇报,而不是一个想到什么就喊什么的话痨。
这也是我们和 DeepSeek 的一个不一样的地方。
他们的内部实例可以主动去修问题,我们的主动助理更偏向"先筛再汇总"——先把信息过一遍,有价值的再递到主助手手里。
要不要行动、怎么行动,主助手和用户一起决定。
第四个选择:外部事件来了,要不要打断用户?
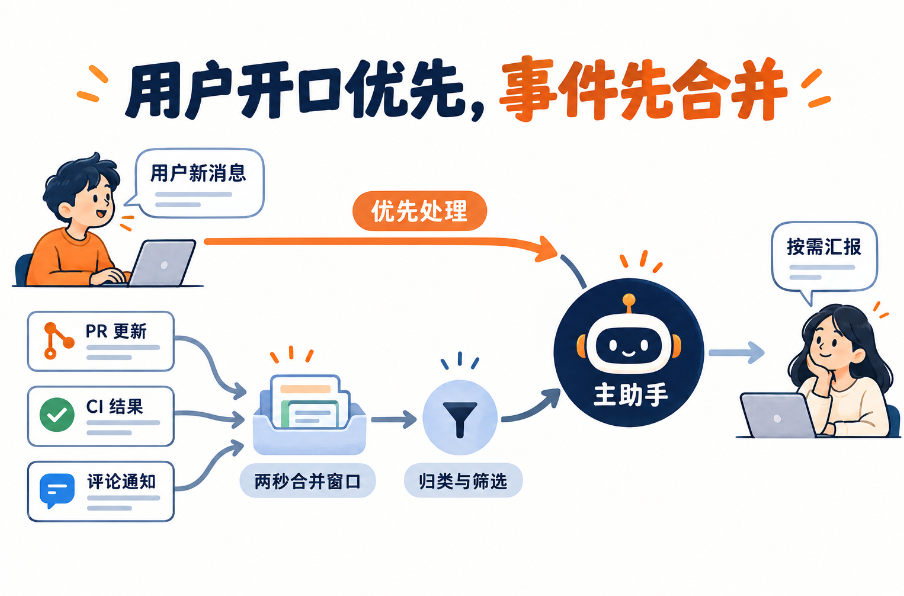
外部事件合并窗口
除了用户自己发的消息,系统还会收到很多外部事件:PR 合并了、CI 挂了、有人评论了、新邮件来了……
这些事件要不要立刻告诉用户?
我们的答案是:先合并,再判断。
外部事件有一个两秒的合并窗口。同一段时间涌进来的一堆事件,先攒一下,归个类,分个优先级,再决定要不要推给主助手、推给用户。
为什么?
因为外部事件和用户主动说话不一样。
用户主动说的话,优先级最高,要立刻响应。但系统产生的杂讯,如果来一条推一条,用户会被烦死。
这里的原则很简单:用户开口优先,系统杂讯先筛一遍。
DeepSeek 的方案里也有类似的思路——群消息先用程序滤掉噪音,再交给模型判断。
大家都在往同一个方向走:让 Agent 学会区分"重要的事"和"背景噪音"。
跑上生产之后,才发现的那些事
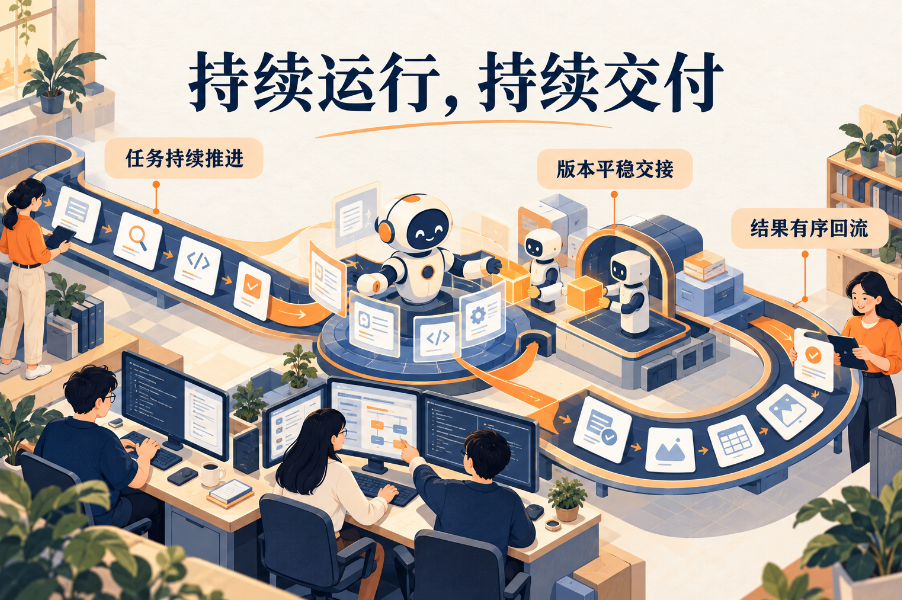
跑上生产之后
讲完了设计选择,再聊几个真正跑起来之后才遇到的问题。
这些问题论文里不会写,架构图上也看不出来,但每一个做生产的团队都会碰到。
长任务和版本升级怎么共存?
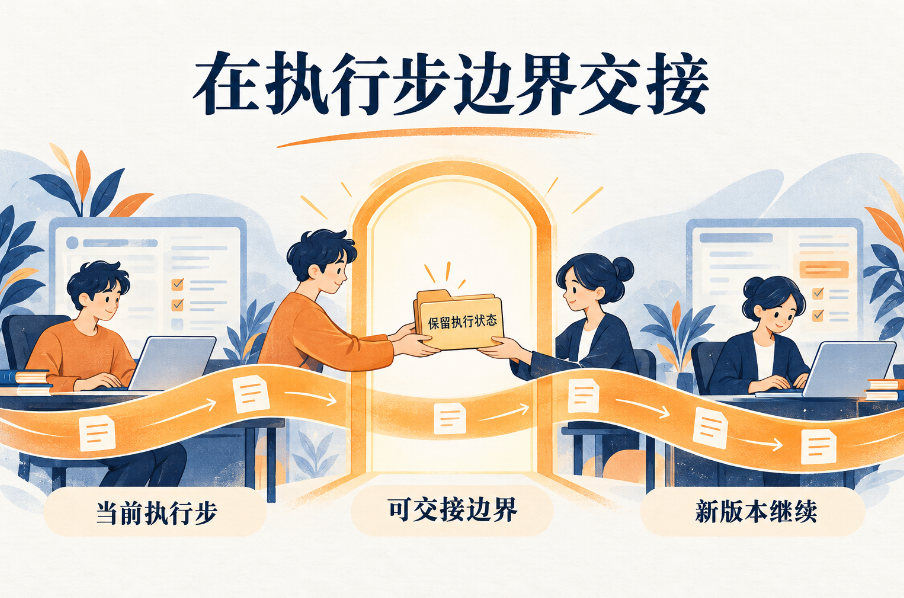
执行步边界做版本交接
Agent 有时候会跑很长的任务——修一个复杂的 bug、写一大段代码、做一次完整的调研,可能要跑几十分钟甚至更久。
但系统不可能不升级。
总不能因为有任务在跑,新版本就永远发不出去吧?
我们的解法是在执行步的边界做交接。
跑完当前这一步、等待后台工具的时候,如果有新版本要上线,就把当前状态整理好,平滑交接给新版本。新版本接手之后继续往下跑。
不是任何时刻都能强杀切版本,也不是所有任务都能无损秒切。
做过的人都懂,能在步边界平滑交接,已经是生产环境里很实用的方案了。
迟到的结果怎么接回来?
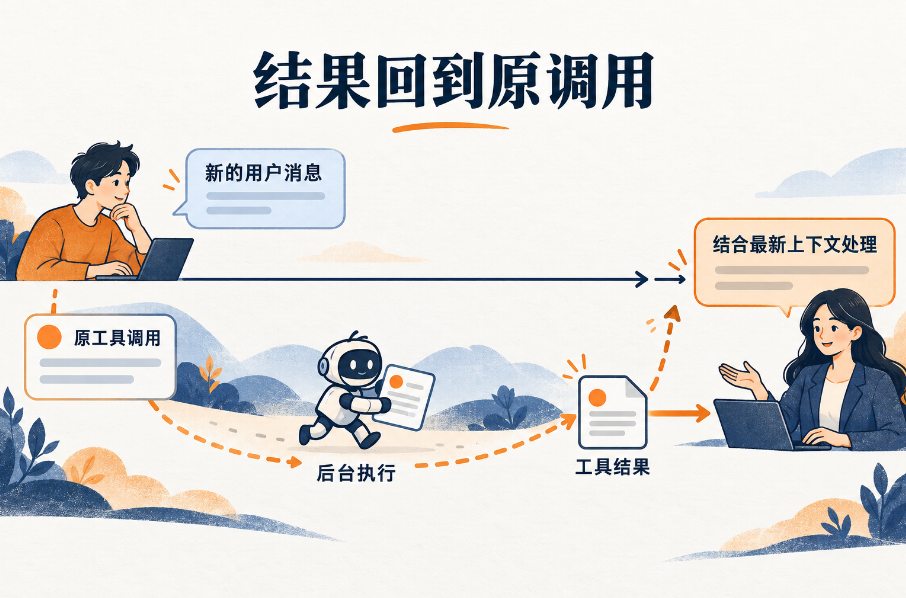
后台结果回流
工具切到后台跑,跑着跑着完了。这时候用户可能已经聊到别的话题了。
这个结果怎么接回来?
不能直接插队——用户正在说别的事,你突然插一个"刚才那个工具跑完了",对话节奏就乱了。
也不能丢了——用户明明让查的东西,查完了不说,等于没查。
我们的做法是保留工具调用的原始身份。工具跑完之后,结果补回到原来那次调用里,再交给模型继续处理。
模型根据当前对话上下文,决定怎么把这个结果带进对话里。
这不是一个完美的方案,但在生产里够用了。
最后说几句
DeepSeek 的这篇 Super-agent 文章,我们看完是很有共鸣的。
因为我们知道,往这个方向走的人,思考的问题都差不多——怎么让用户不用管理一堆会话、怎么让工具不阻塞对话、怎么让主动功能不变成骚扰、怎么在持续运行中保持稳定。
他们画出了一张很清晰的蓝图。我们在生产环境里,把蓝图上的一些点踩成了脚印。
Super Agent 的时代确实在来。
但从论文到生产,中间隔着的不是一个数量级的代码量,而是无数个真实用户的使用场景、无数个半夜排查的 bug、无数个"看起来对但用起来不对"的设计选择。
我们还在路上。DeepSeek 也在路上。
这个方向才刚刚开始。
如果你也在做类似的事情,欢迎来聊——踩过的坑多了,路就出来了。